
Token 与用量怎么看:先认单位,再看自己的额度
📊 Token 是处理信息的数量,不是提问次数,也不是套餐承诺。 判断还够不够用,先看账号当前的额度和恢复时间。
📑目录
一、这些数字有多大
Token 可以理解为模型处理信息的小单位,和汉字没有固定换算比例。
| 写法 | 数量 |
|---|---|
| 1K | 一千 |
| 1M | 一百万 |
| 50M | 五千万 |
| 1B | 十亿 |
你的问题、历史对话、文件、工具结果和模型回复,都可能参与统计。最后只回复几句话,过程也可能处理了很多材料。
二、输入缓存输出怎么分
📥 输入:带给模型的要求、资料和上下文。
♻️ 缓存输入:复用的输入部分,先看统计工具是否已把它计入输入。
📤 输出:模型生成的内容,某些统计还包含推理用量。
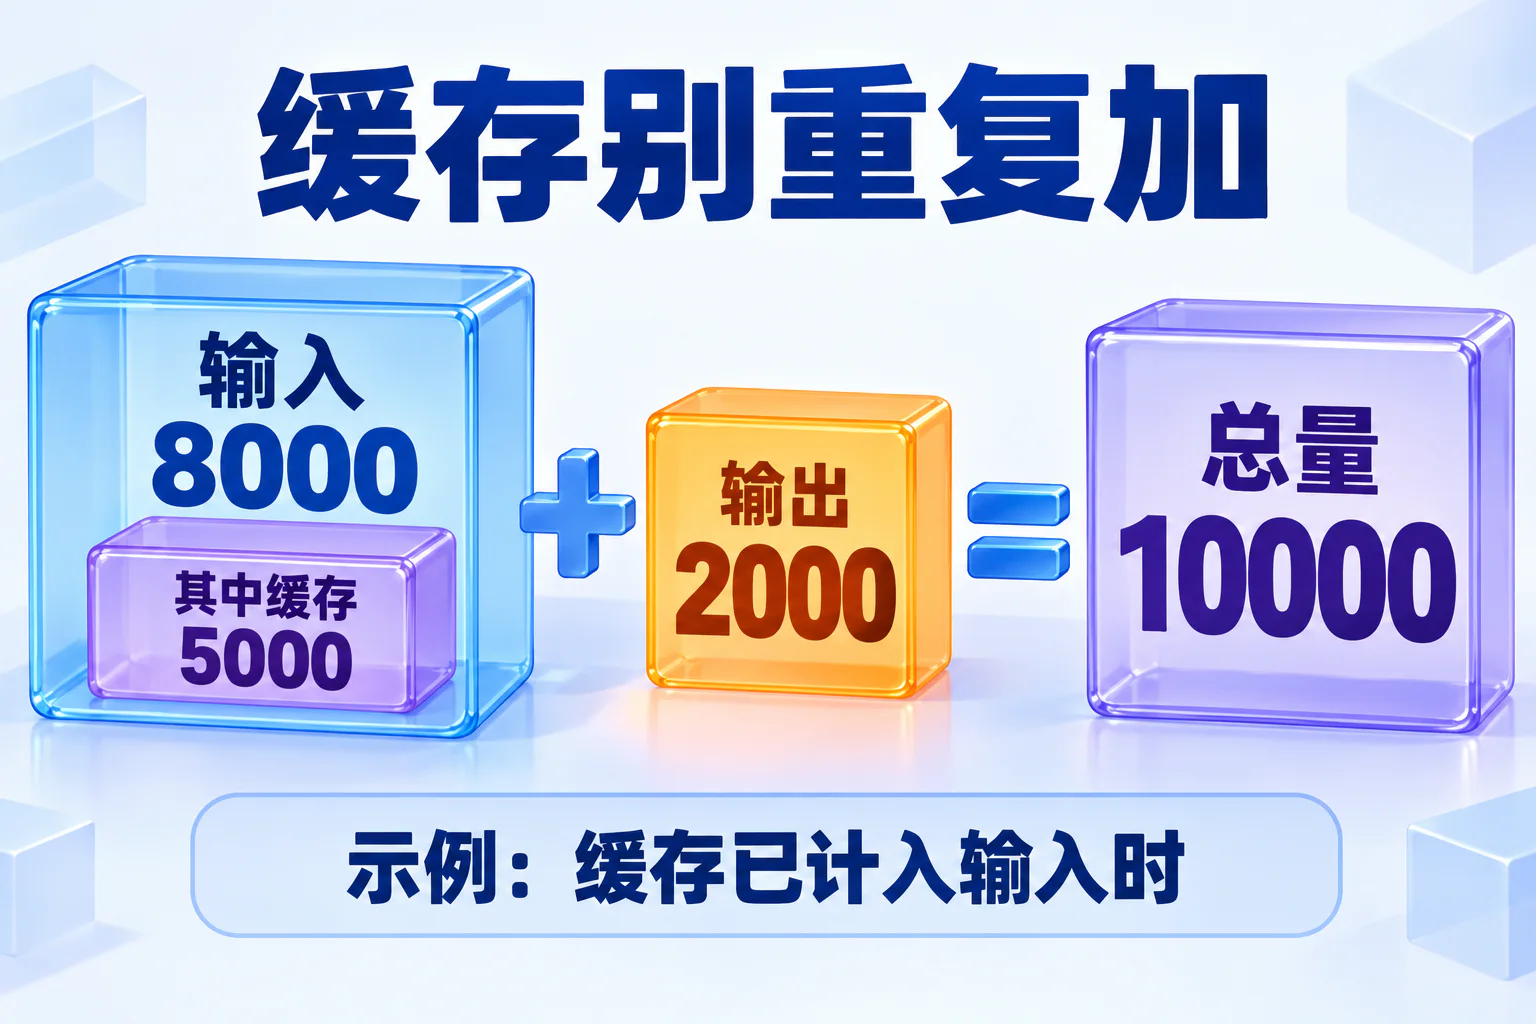
举个算术例子:输入8000,其中缓存5000;输出2000。 如果缓存已包含在输入里,总量就是 10000,不能再加一次5000。
这是示例,不是账号实测。不同工具的字段定义可能不同,先看说明。
三、为什么别人用得更多
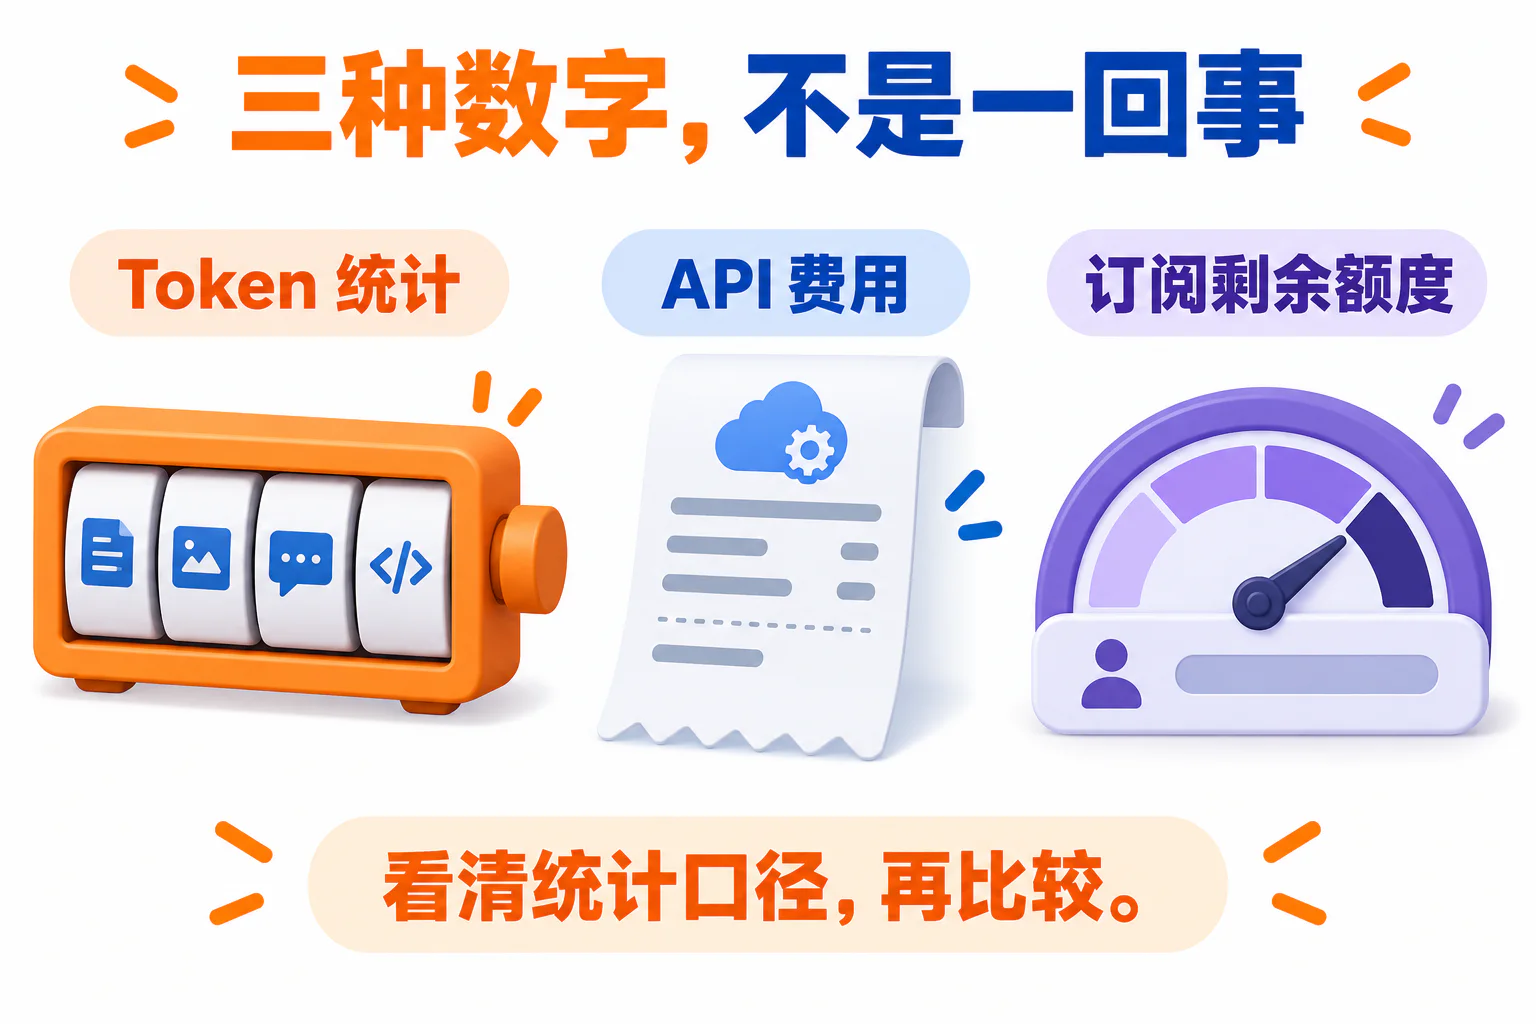
比较截图前,先确认 模型、统计周期、缓存口径是否相同。一次任务的数字,不能直接和别人一周的总量比较。
🧠 模型、任务难度、上下文和工具使用都会影响消耗。第三方 Token 统计、API 费用与订阅剩余额度,是不同口径。
额度以当前账号页面为准;不要拿“别人用了几亿”当作自己的套餐保底。
四、怎样判断要不要升级
挑几次常做的任务,简单记下:
用了什么模型,做了什么任务,开始前和结束后还剩多少额度,有没有被限额打断。
例如剩余80%变成74%,减少的是 6个百分点;如果期间还有其他任务或额度重置,就不能都算到这一次。